文章标签
处理
-
Transformer模型推理优化:不改模型结构,提升文档摘要系统效率
在人工智能领域,特别是自然语言处理任务中,Transformer模型凭借其强大的表征能力,在长文档摘要这类复杂任务上表现出色。然而,其巨大的参数量和计算复杂度,在实际部署时常常带来性能挑战:每次生成摘要都需要消耗大量计算资源和时间,严重影...
-
C++ 字符串处理新纪元:std::string_view 的应用与性能优化
嗨,各位 C++ 程序员们,我是老张,一个在代码世界里摸爬滚打多年的老兵。今天咱们聊聊 C++ 字符串处理这个老生常谈的话题,但这次咱们要关注一个新朋友—— std::string_view 。相信不少同学都听过它的名字,但可能还没来得及...
-
Hadoop和Spark的比较:何时使用各自的优势?
当谈到大数据处理时,Hadoop和Spark是两个最常被提及的技术。虽然它们都可以处理大量数据,但在设计理念、应用场景和性能优化方面存在明显的差异。 Hadoop是一个经典的批处理系统,与MapReduce紧密结合,擅长处理大量离线数...
-
基于Apache Flink的实时特征计算架构:应对海量交易数据低延迟高吞吐挑战
在金融、电商、广告等领域,面对海量高并发的交易数据,如何设计一套低延迟、高吞吐的特征计算架构,为风控、推荐、反欺诈等实时决策系统提供精准特征,是每个大数据团队都必须面对的挑战。特别是对序列特征和图特征的实时提取,更是技术难点。 1....
-
Node.js 性能优化秘籍:setImmediate() 与 process.nextTick() 的实战指南
嘿,老铁们,我是老码农,今天咱们来聊聊 Node.js 性能优化的一个重要话题: setImmediate() 和 process.nextTick() 这两个看起来有点“神秘”的 API。 它们就像 Node.js 的“秘密武器”...
-
Node.js 分布式任务系统:Redis Pub/Sub 实现实时任务分发与状态同步
Node.js 分布式任务系统:Redis Pub/Sub 实现实时任务分发与状态同步 大家好,我是你们的赛博朋克老友“码农老炮儿”。今天咱们来聊聊 Node.js 分布式任务系统里一个挺有意思的话题:怎么用 Redis 的 Pub/...
-
Redis 热点 Key 深度剖析:电商秒杀场景实战指南
你好,我是老码农。今天咱们聊聊 Redis 在电商系统中的一个常见且棘手的问题——热点 Key。尤其是在秒杀这种高并发场景下,热点 Key 带来的挑战更是让人头疼。我将结合实际案例,深入分析热点 Key 的危害、产生原因,以及如何有效地应...
-
数据采集链路的端到端监控实践:确保数据完整性与准确性
数据是现代企业运营和决策的核心。然而,从用户行为的客户端埋点到数据最终落盘并被分析利用,整个数据采集链路充满了潜在的风险点,可能导致数据丢失、不准确或不完整。如何建立一套 端到端(End-to-End)的数据采集链路监控体系 ,确保数据的...
-
NestJS 进阶:中间件、错误处理与日志记录的完美结合,以及对接第三方监控平台
NestJS 进阶:中间件、错误处理与日志记录的完美结合,以及对接第三方监控平台 大家好,我是你们的“代码搬运工”小猿。今天咱们来聊聊 NestJS 开发中至关重要的几个环节:中间件、错误处理和日志记录。更进一步,我们还会探讨如何将这...
-
大数据处理中的数据安全问题解析
随着大数据时代的到来,数据处理和分析已经成为各行各业的重要手段。然而,在享受大数据带来的便利的同时,我们也面临着数据安全的问题。本文将详细解析大数据处理中的数据安全问题,帮助读者了解数据安全的重要性以及如何防范数据安全风险。 数据安全...
-
使用Python进行数据处理的最佳实践与工具推荐
在当今数据驱动的时代,数据处理已成为一项不可或缺的技能。随着Python语言的崛起,越来越多的专业人士开始使用它进行数据处理。那么,怎样在Python中实现高效的数据处理呢? 1. 数据处理的基本概念 数据处理是指通过一系列步骤对...
-
C++协程在嵌入式系统中的优化之道?性能、内存与CPU的三重奏
C++协程在嵌入式系统中的优化之道?性能、内存与CPU的三重奏 作为一名在嵌入式领域摸爬滚打多年的老兵,我深知资源受限环境下的开发有多么捉襟见肘。C++协程的出现,无疑为我们提供了一种在有限资源下实现高并发的可能。但理想很丰满,现实很...
-
Python图像格式转换:从小白到熟练掌握
Python图像格式转换:从小白到熟练掌握 在日常的图像处理工作中,我们经常需要将图像从一种格式转换为另一种格式。例如,将JPEG图片转换为PNG,或者将TIFF转换为GIF。Python凭借其强大的图像处理库,可以轻松完成这项任务。...
-
交叉验证详解:K折、分层K折与留一法,选对才靠谱
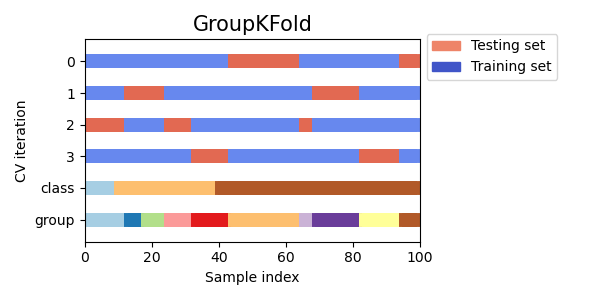 兄弟们,咱们搞机器学习,模型训练完,总得知道它几斤几两吧?最常用的方法就是划分训练集和测试集。简单粗暴,一分为二,训练集练兵,测试集大考。但这就像高考前只做一套模拟题,万一这套题特别简单或者特别难,或者刚好考的都是你擅长/不擅长的知识点呢...
-
WebAssembly SIMD 加速指南:图像处理与科学计算的性能飞跃
你好!我是你们的“码力十足”小编。今天咱们来聊聊 WebAssembly(简称 Wasm)里一个超酷炫的技术——SIMD。如果你是一位对性能有极致追求的开发者,尤其是有 SIMD 编程经验的小伙伴,那这篇文章绝对能让你眼前一亮! SI...
-
构建高性能、低成本的实时历史数据平台:架构策略与技术选型
在当今数据驱动的时代,构建一个既能处理实时交易数据,又能支持秒级查询十年历史数据的平台,同时还要严格控制存储和运维成本,无疑是许多企业面临的核心挑战。特别是来自多业务线的数据汇聚,更是将复杂性推向新的高度。本文将深入探讨这一难题的架构策略...
-
编程语言中常用的文本处理库有哪些?
在当今的软件开发世界中,文本处理是一个不可或缺的技能。无论是处理用户输入、解析文件内容,还是基于文本进行数据分析,各种编程语言都有其独特的文本处理库和工具。以下是一些主流编程语言中常用的文本处理库,帮助开发者选择合适的工具进行开发。 ...
-
Python 字符编码解码真经:告别乱码与 UnicodeDecodeError
作为一个 Python 开发者,你是不是经常被乱码、 UnicodeDecodeError 这些问题搞得焦头烂额?别担心,今天咱们就来聊聊 Python 里的字符编码和解码,让你彻底告别这些烦恼! 1. 编码和解码:从人类语...
-
如何有效配置Spark Streaming以处理高并发数据流?
在当今的互联网时代,高并发的数据流处理已成为许多企业的数据架构中的核心要素。在这样的背景下,Apache Spark的流处理框架Spark Streaming因其高效、易用而备受青睐。但是,如何有效配置Spark Streaming以处理...
-
Kafka在实时数据传输中的优势:一个电商平台的案例分析
Kafka在实时数据传输中的优势:一个电商平台的案例分析 近几年,随着电商平台的蓬勃发展,实时数据处理的需求日益增长。海量的用户行为数据、订单数据、库存数据等需要被实时采集、处理和分析,以支持个性化推荐、精准营销、库存管理等业务需求。...